从 pixivic 到 ShareMoe,八年历程,在 ai 时代重新出发,just for fun~
为什么是 ShareMoe?
最全:pixiv+danbooru
以 Danbooru 与 Pixiv 的公开插画元数据为基础,打通两个最大二次元插画分发平台的物料,统一进行分发。
在数据补全方面,ShareMoe 基于前序开源的ACG2Vec项目中的 pix2score 模型,对 danbooru 作品的元数据进行预估补全,包括:
sanity分级预估- 收藏数预估
- 浏览数预估
这些结果用于改善检索、排序和浏览初始体验,for 对齐 pixiv 平台的后验值,不替代真实统计数据。后续探索基于保序回归的新版本。
最准:从标签匹配到内容理解
不管是 pixiv 或者是 danbooru,检索仍然以文本粒度的 term 匹配+全文分词倒排作为实现,语义泛化能力差;在这种关键词硬匹配的背景下,danbooru 侧更是缺少用户反馈,后验信息缺失,导致朴素排序结果较差,pixiv 为了高级会员差异性,劣化了普通用户的搜索体验(无法进行热度排序)
我们建设从多模态内容理解到语义检索、召回和排序的完整方案。
LLM 增强的画作语义表征基座
基础表征方案由两个模型组成:上游多模态大模型负责离线生产高质量的领域语义数据,超大规模二次元图文对微调的 embedding 模型负责把图像与不同粒度的文本映射到同一个向量空间。
画作与原始元数据 → 标签知识增强 → 多模态内容理解 → 结构化语义数据 → 多粒度图文配对 → 分阶段 embedding 微调 → 向量化与 ANN 检索。
结构化多模态内容理解:从图像生成可追溯的结构化理解
基于Qwen/Qwen3.5-35B-A3B 产出插画单位的结构化内容理解数据
-
用领域知识补足原始标签
原始标签通常只有短词,无法完整表达角色、作品/IP、别名和上下位关系。我们将画作图像、标题、原始标签与可用的标签知识共同送入内容理解流程:
- Pixiv 标签侧补充中文名、描述、层级分类、父子标签及关联标签等信息;
- Danbooru 标签侧补充标准名称、标签类别、频次和别名映射;
- 角色、作品/IP、画师、一般语义和元标签分开组织,减少同名实体和别名带来的歧义;
- 外部知识只作为识别线索,最终仍要求模型回到图像确认可见事实,无法确认的内容保留低置信度或空值。
-
产出结构化理解
内容理解模型同时参考图像和元数据,输出分层结果,而不是只生成一段泛化描述。主要信息包括:
理解层 典型内容 作用 总体描述 角色/IP、外观、服饰、姿态、场景、光影与氛围 支持自然语言搜索和描述配对 视觉属性 人物数量、发型、发色、瞳色、服装、配饰、表情、动作、构图、视角、景别、色彩 将可见内容拆成可组合的检索条件 实体识别 角色名、作品/IP、原创或二创判断、置信度与识别依据 连接标签、画师和作品关系 高层语义 构图概念、视觉表达、情绪和整体氛围 覆盖难以用单一标签表达的画面语义 分层标签 实体、主题、构图和风格等中文短标签 生成不同粒度的训练查询
大规模多阶段领域微调的语义向量化模型
-
构造三种互补的图文监督
结构化结果经过清洗、去重和格式统一后,转换成三类图文配对:
- 单标签配对:将角色、作品/IP 和一般语义标签分别与图像配对,覆盖关键词、属性词和专有实体。
- 多标签组合配对:将角色/IP 标签或随机采样的语义标签组合成一个查询,学习“角色 + 服饰 + 场景”等条件交集。
- 自然语言描述配对:将完整中文描述与图像配对,学习多个视觉属性、关系和氛围在自然语言中的表达。
-
两阶段训练统一图文空间
使用Qwen/Qwen3-VL-Embedding-2B 作为基础模型并采用 LoRA 方式进行领域适配:
- 阶段一:使用单标签图文对训练 1 个 epoch,让基础模型先适应插画领域的角色、作品/IP、属性和标签表达。
- 阶段二:混合单标签、多标签组合和自然语言描述三类数据继续训练 2 个 epoch,使同一个向量空间同时支持关键词搜索、组合条件搜索和完整描述搜索。
- 向量检索:将查询文本和作品内容编码为归一化向量,通过 ANN 索引进行大规模候选召回,再交给后续排序链路处理。
最终在 1%的多阶段测试集上取得显著指标提升
LLM 语义增强的实时全域序列感知的召排模型
推荐系统会综合用户兴趣、作品内容和近期行为,探索多路召回与统一排序:
- 用户双塔召回
- 物品
i2i相似作品召回 - 近期画作序列召回
- 近期画师序列召回
- User-CF 协同过滤召回
- 搜索与推荐共享的多目标、多域排序模型
搜索:语义 ANN 与全文倒排并行
搜索侧结合两类能力:
- 语义 ANN 召回:理解近义表达、画面描述和复杂意图
- 全文分词倒排:保证标签、画师、作品 ID 等精确检索能力
- 相关性、热度、新鲜度融合:用于搜索分粗排
免费多端使用
- flutter 移动端(ios & android)
- react web 与桌面端 (wails)
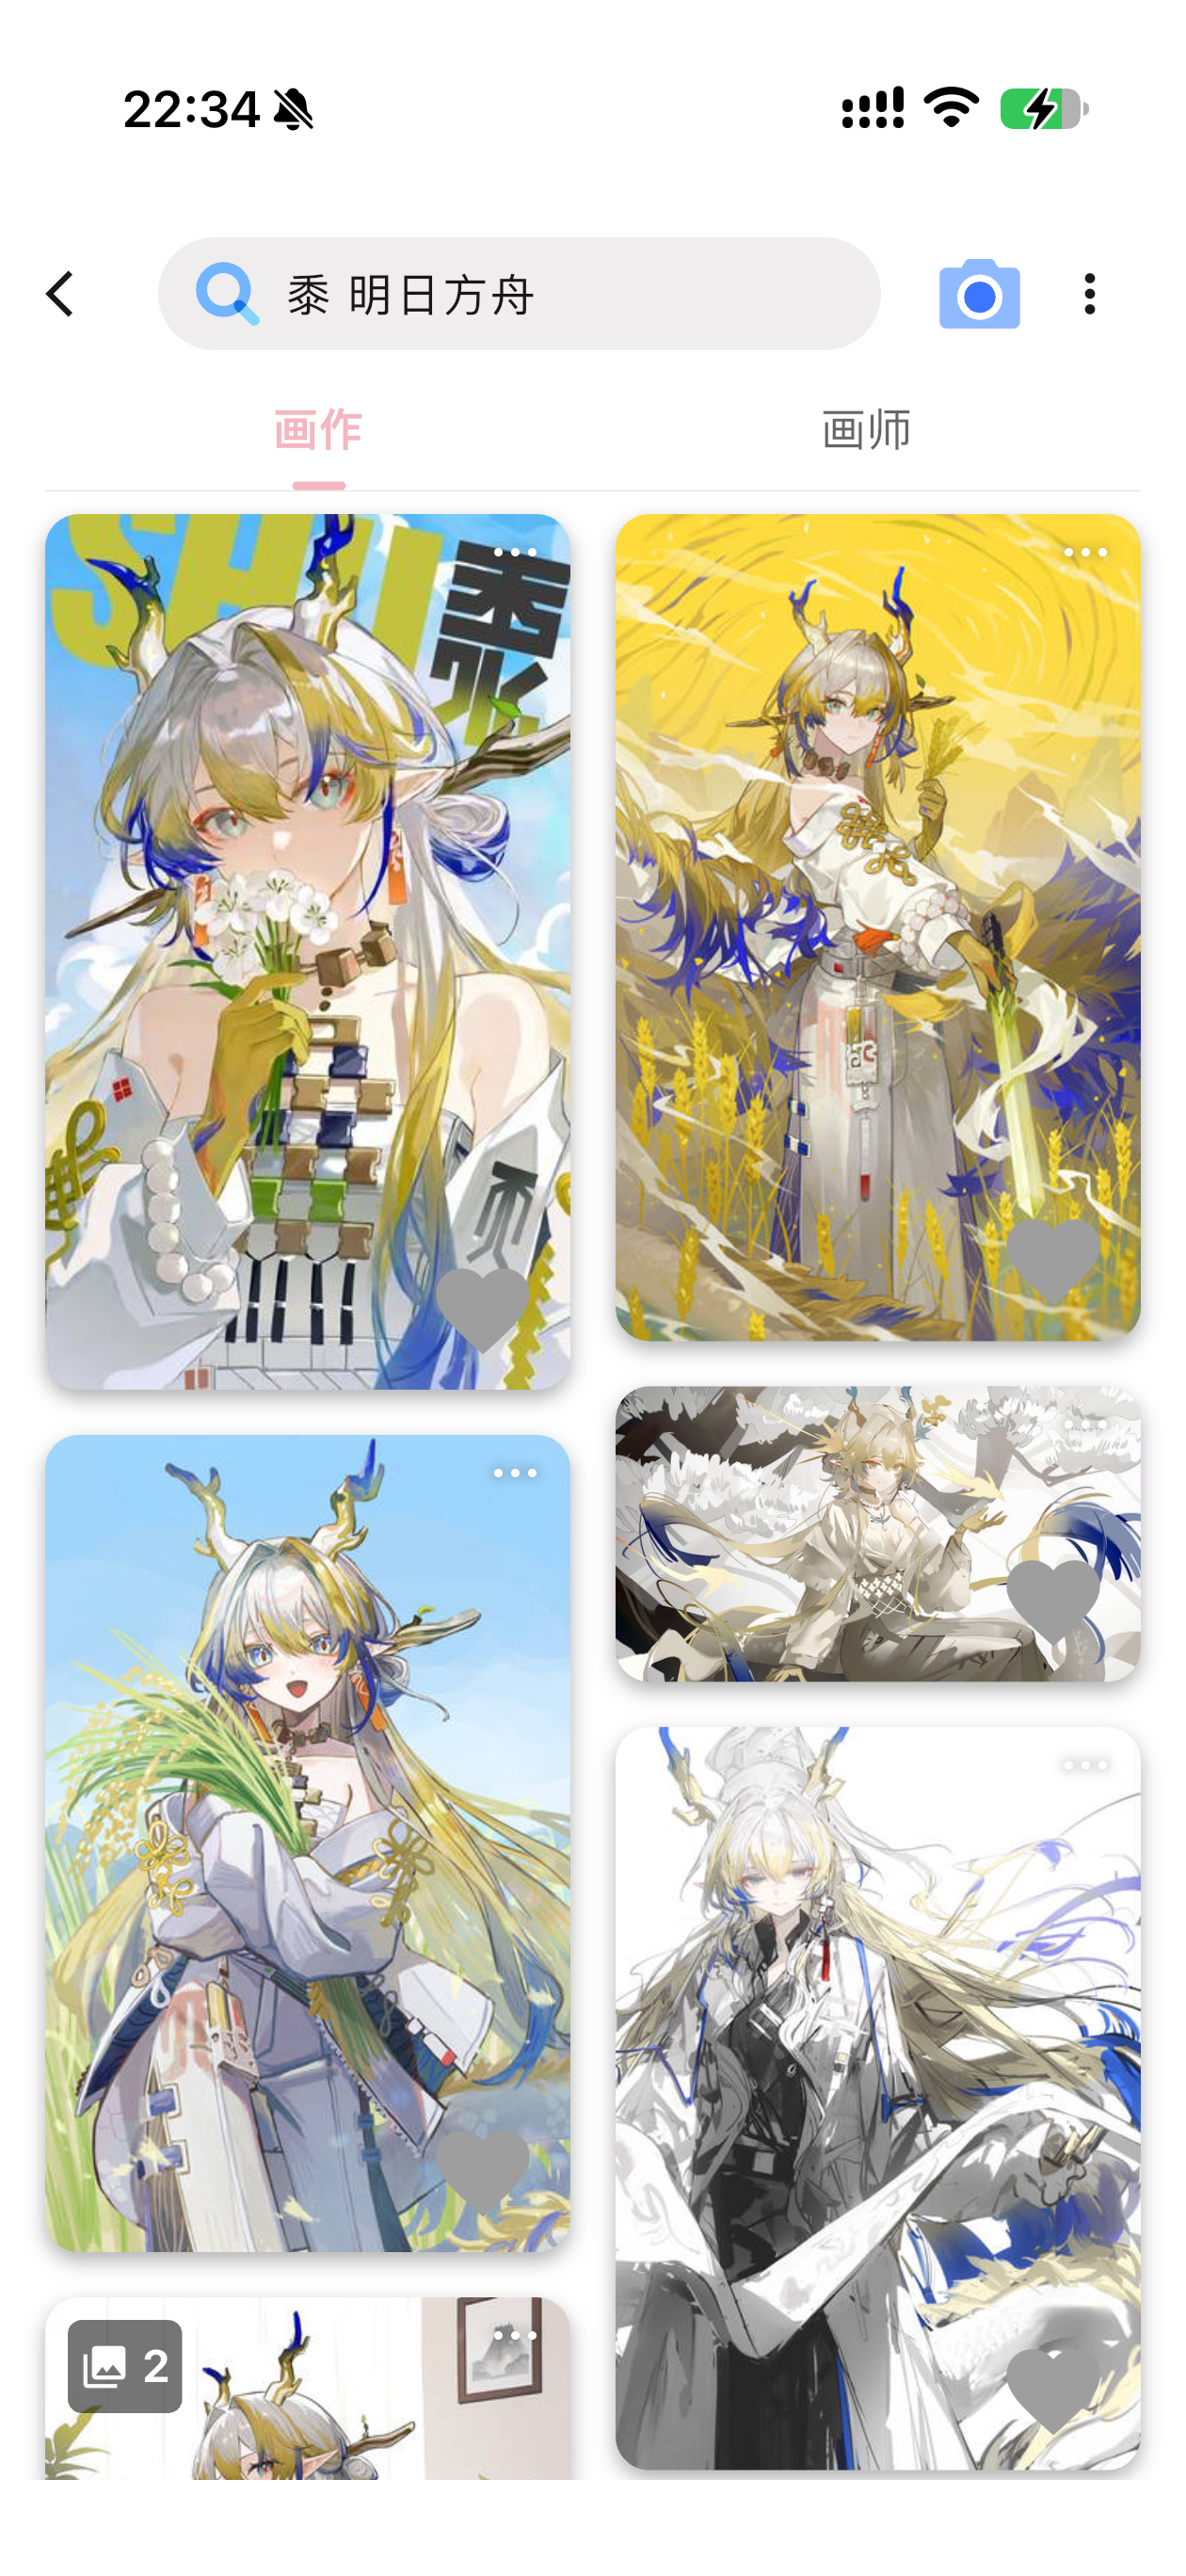
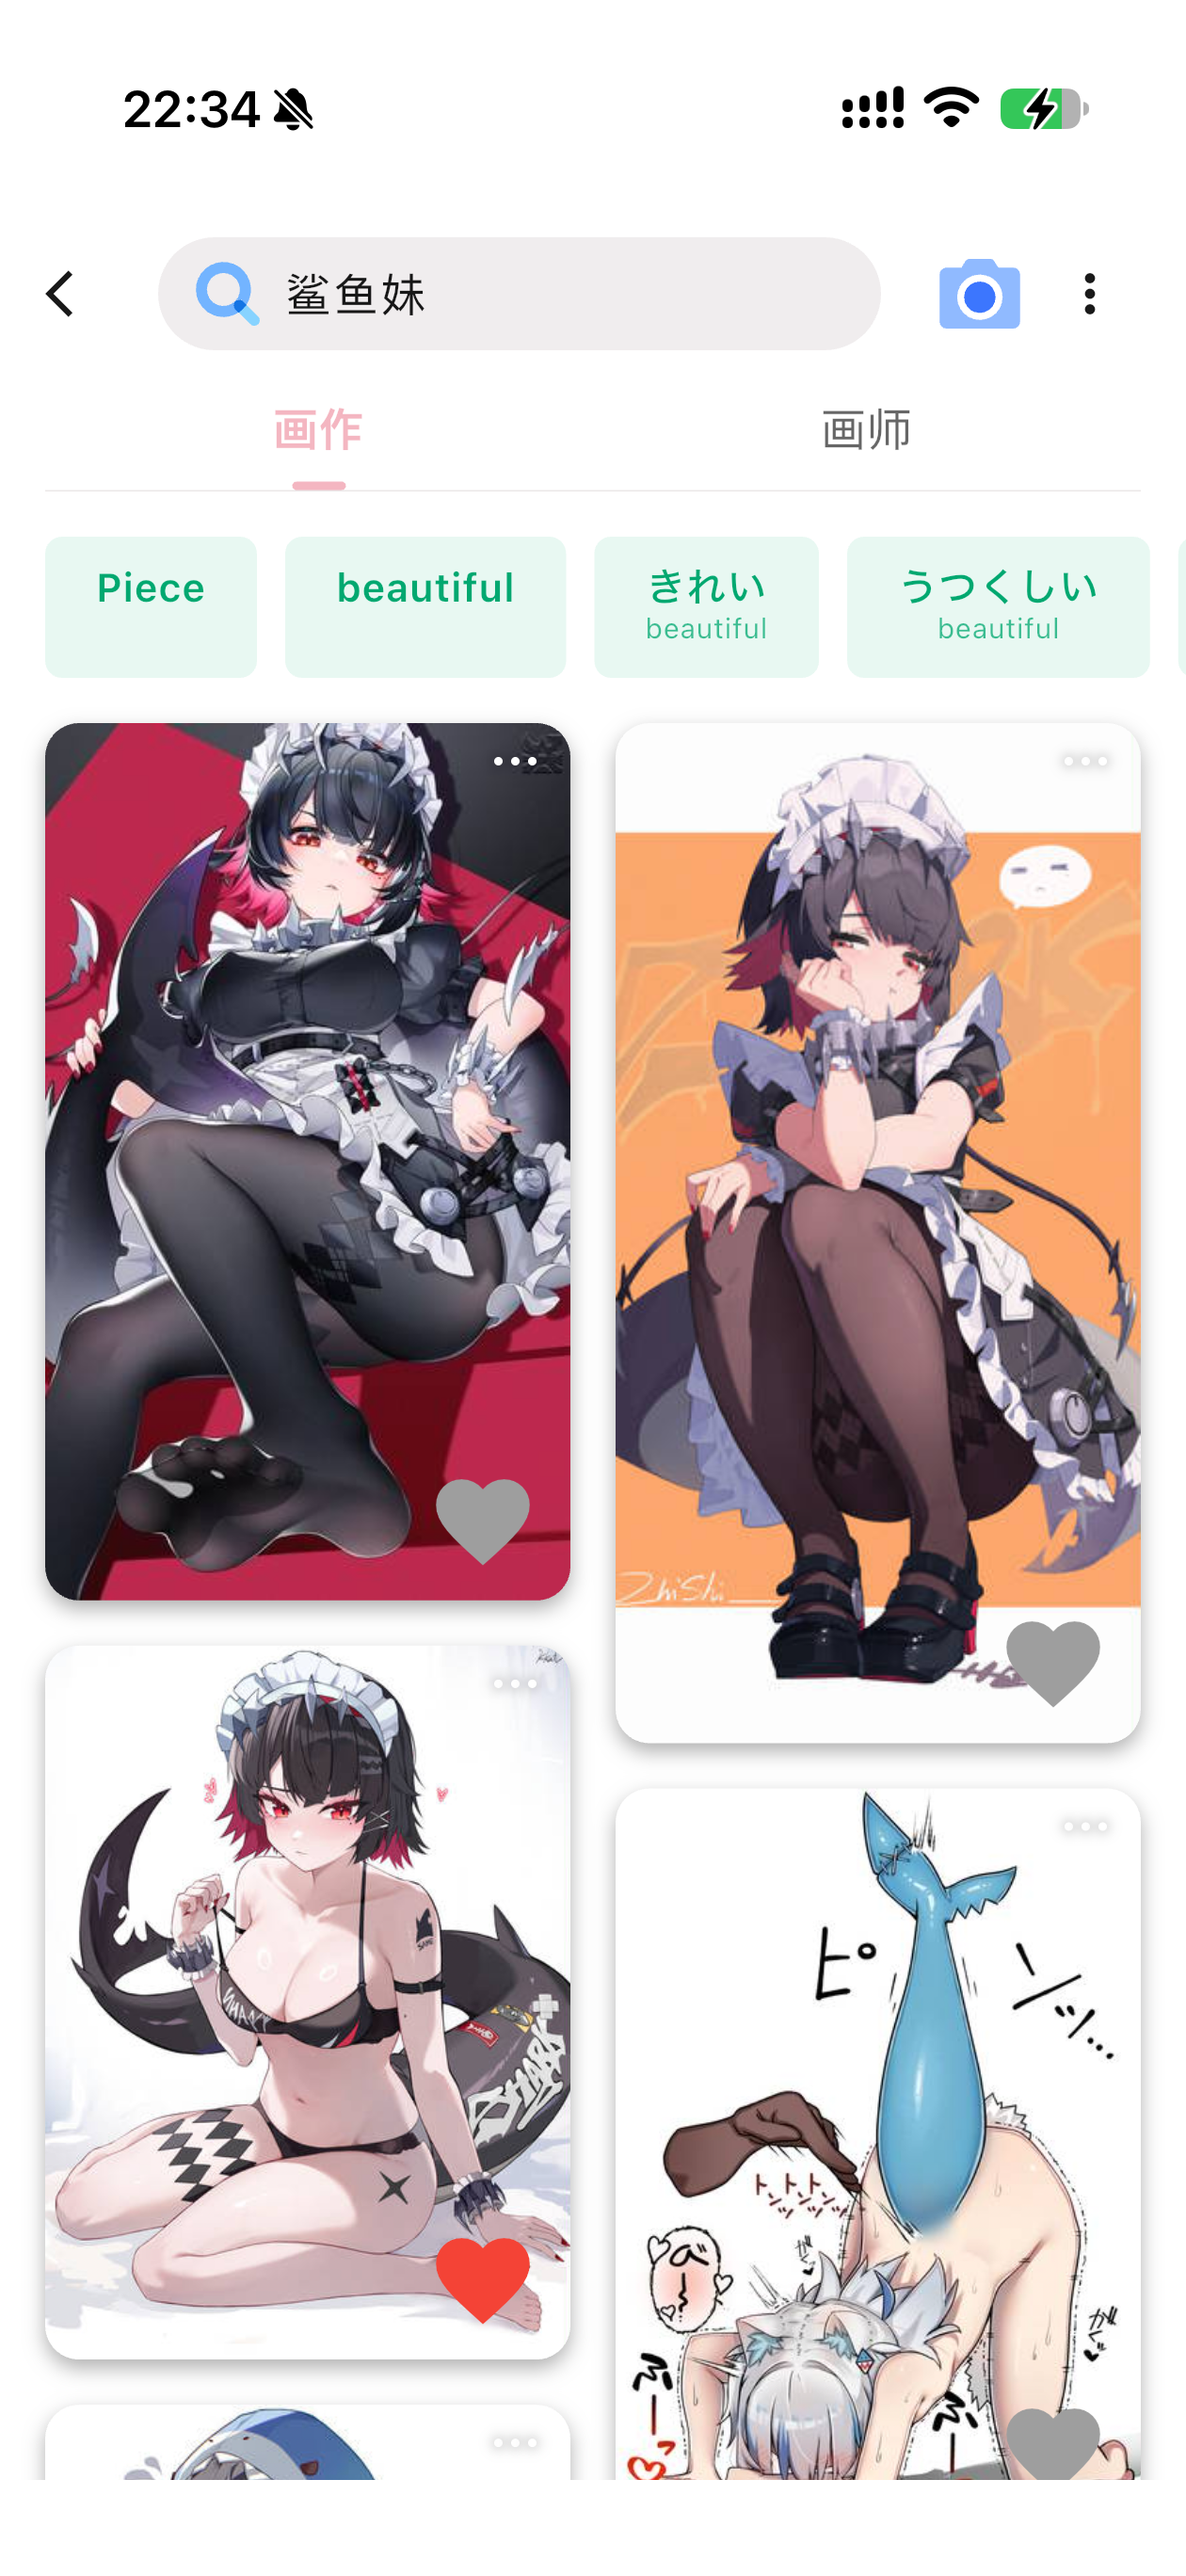
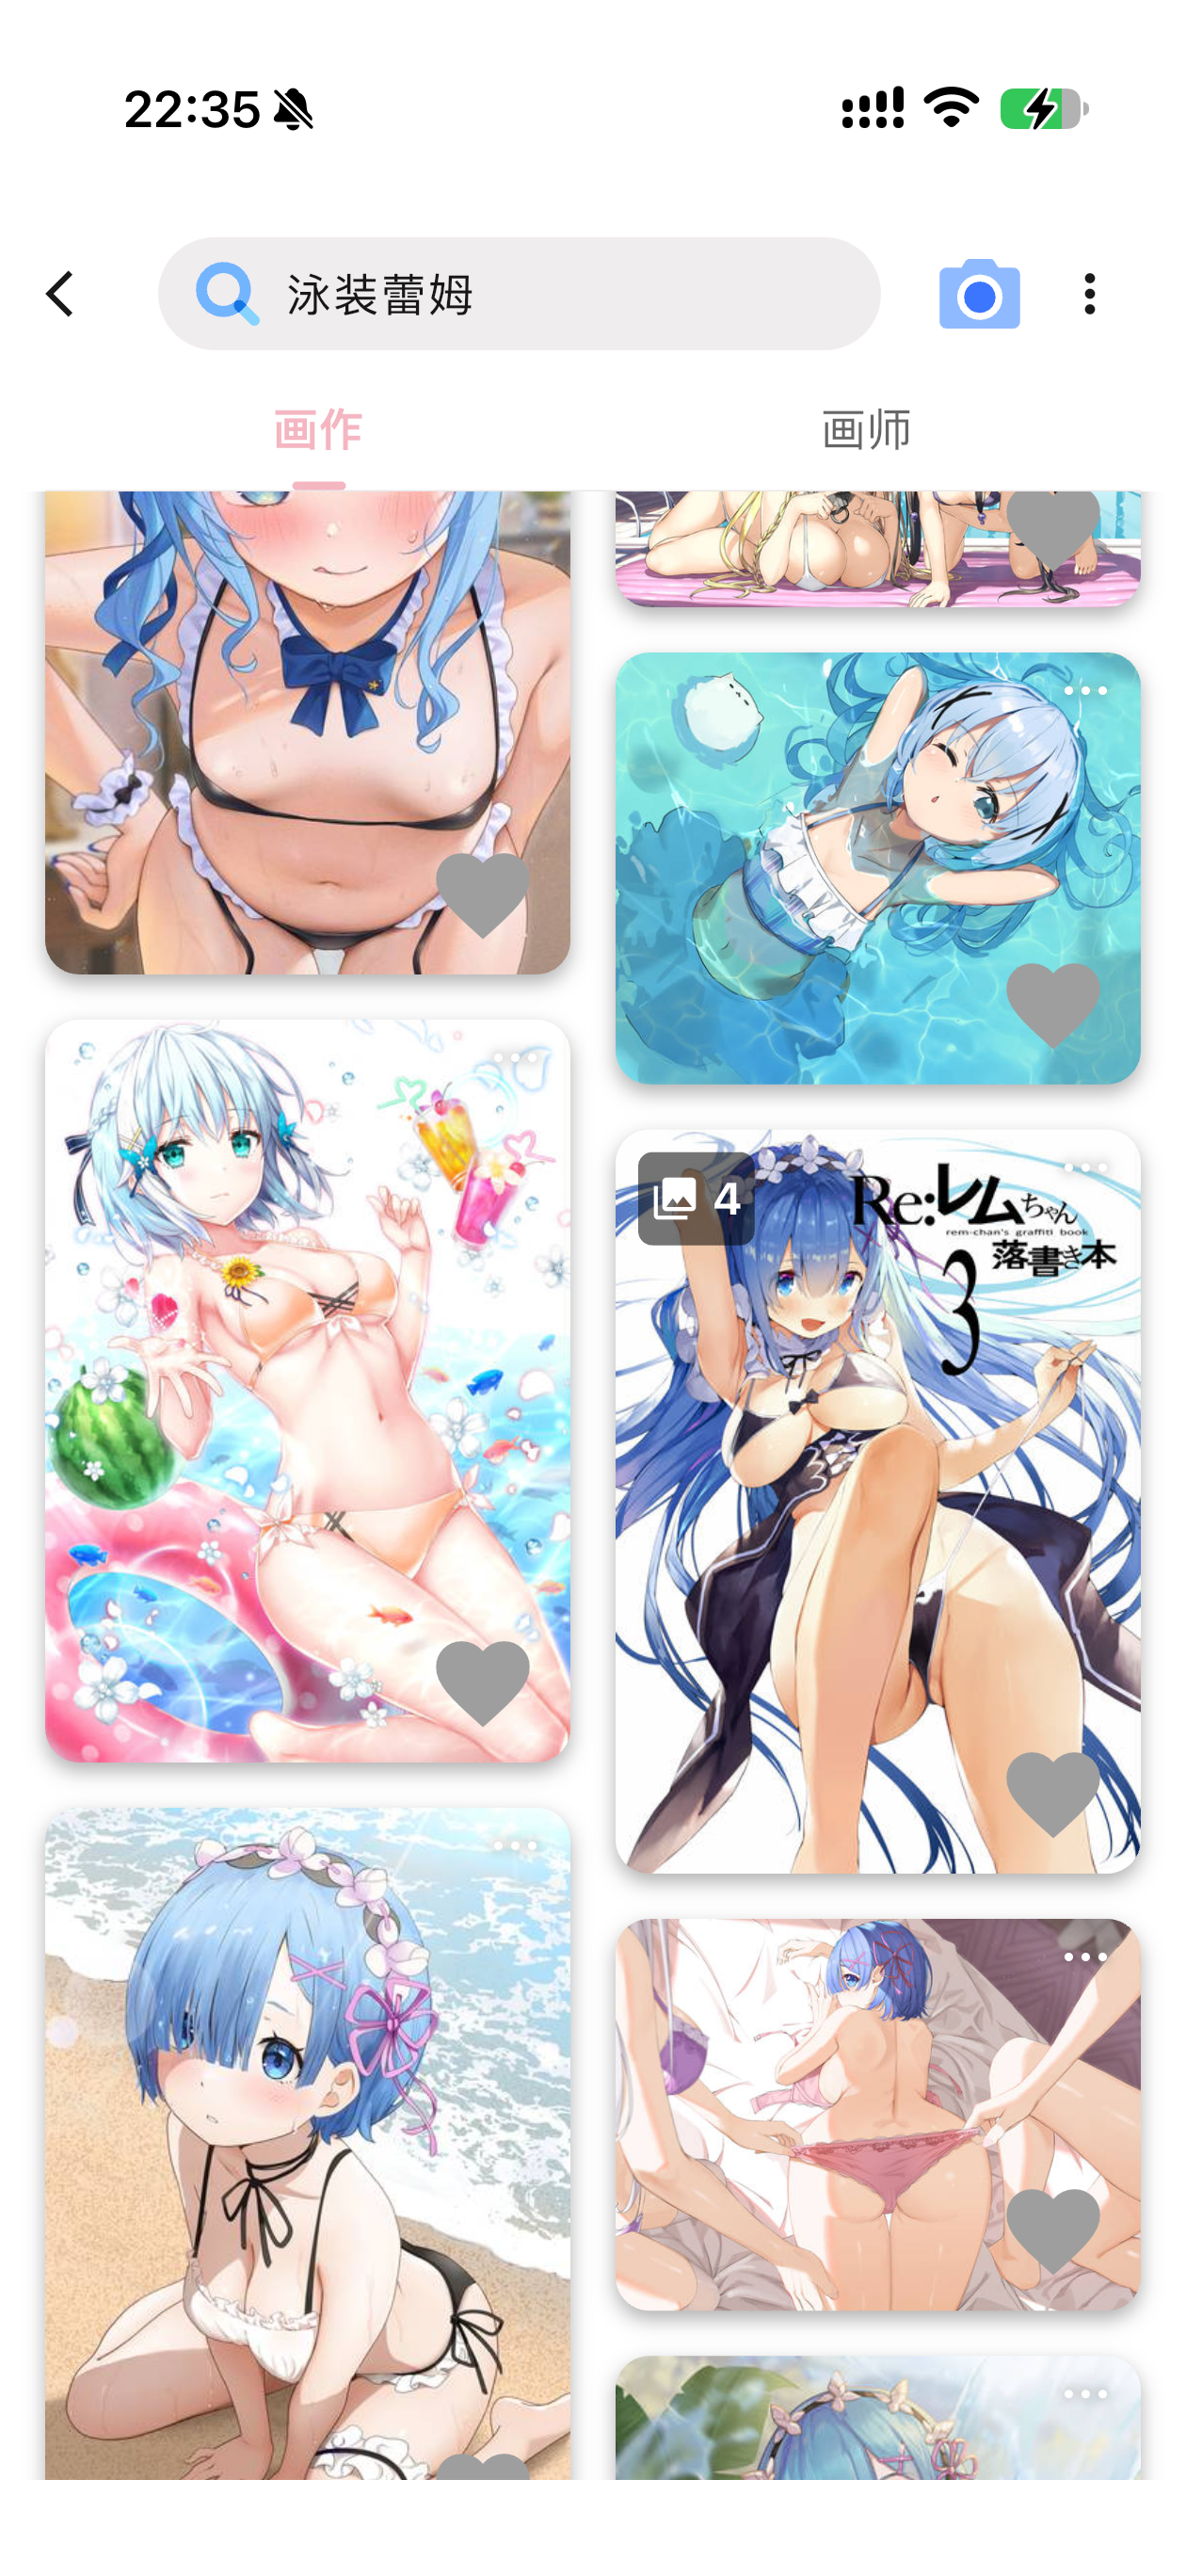
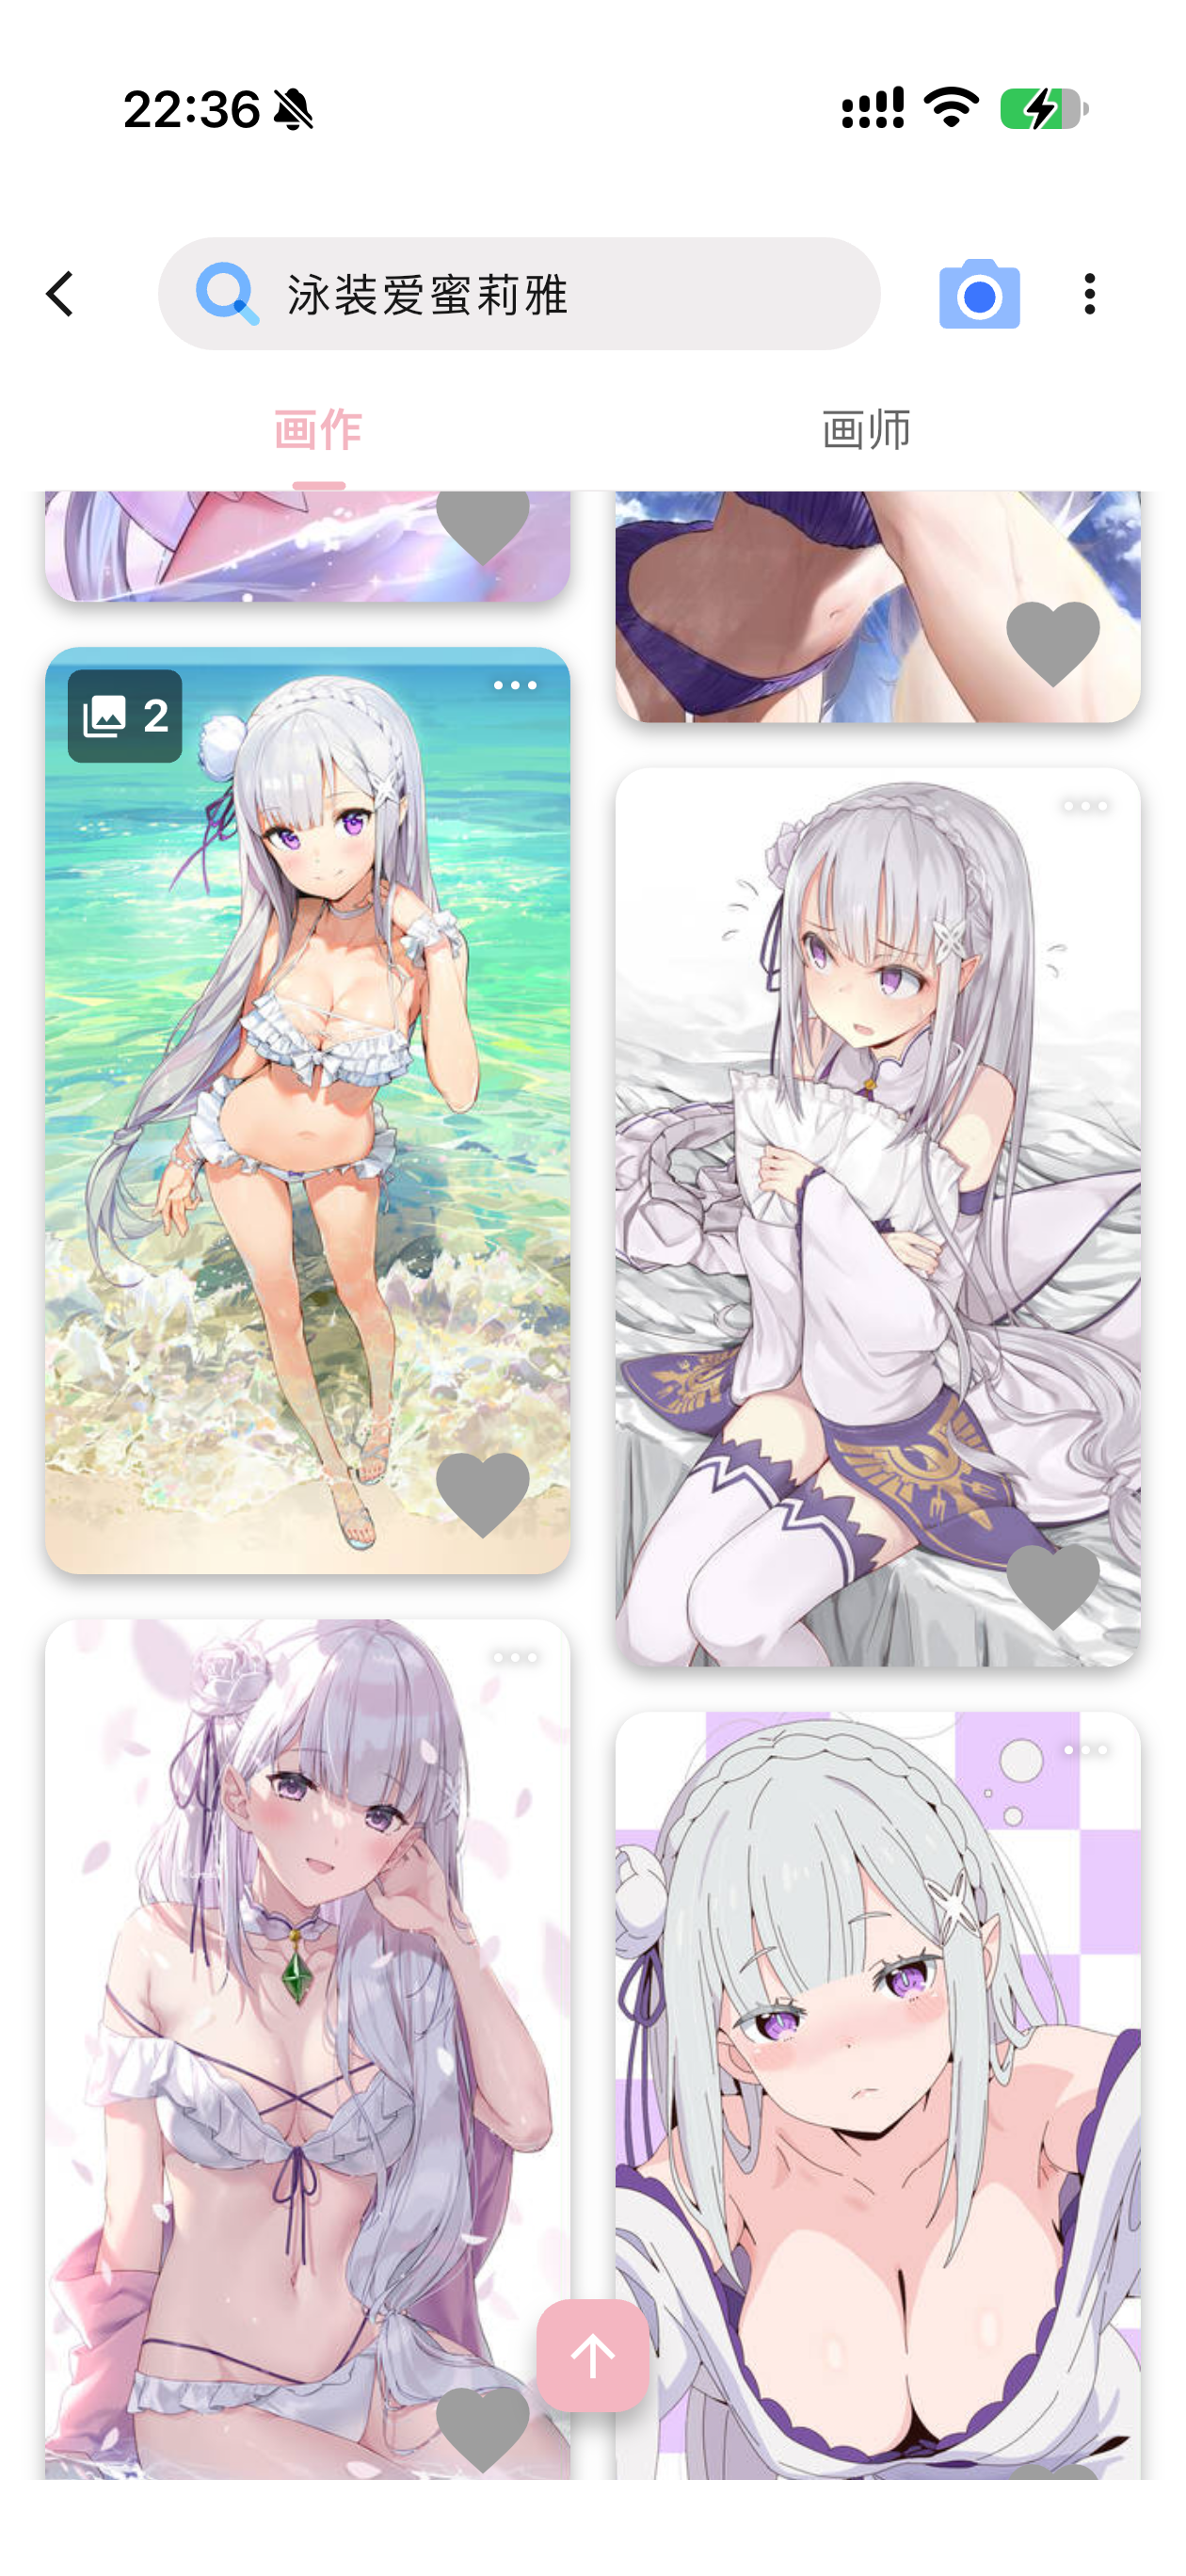
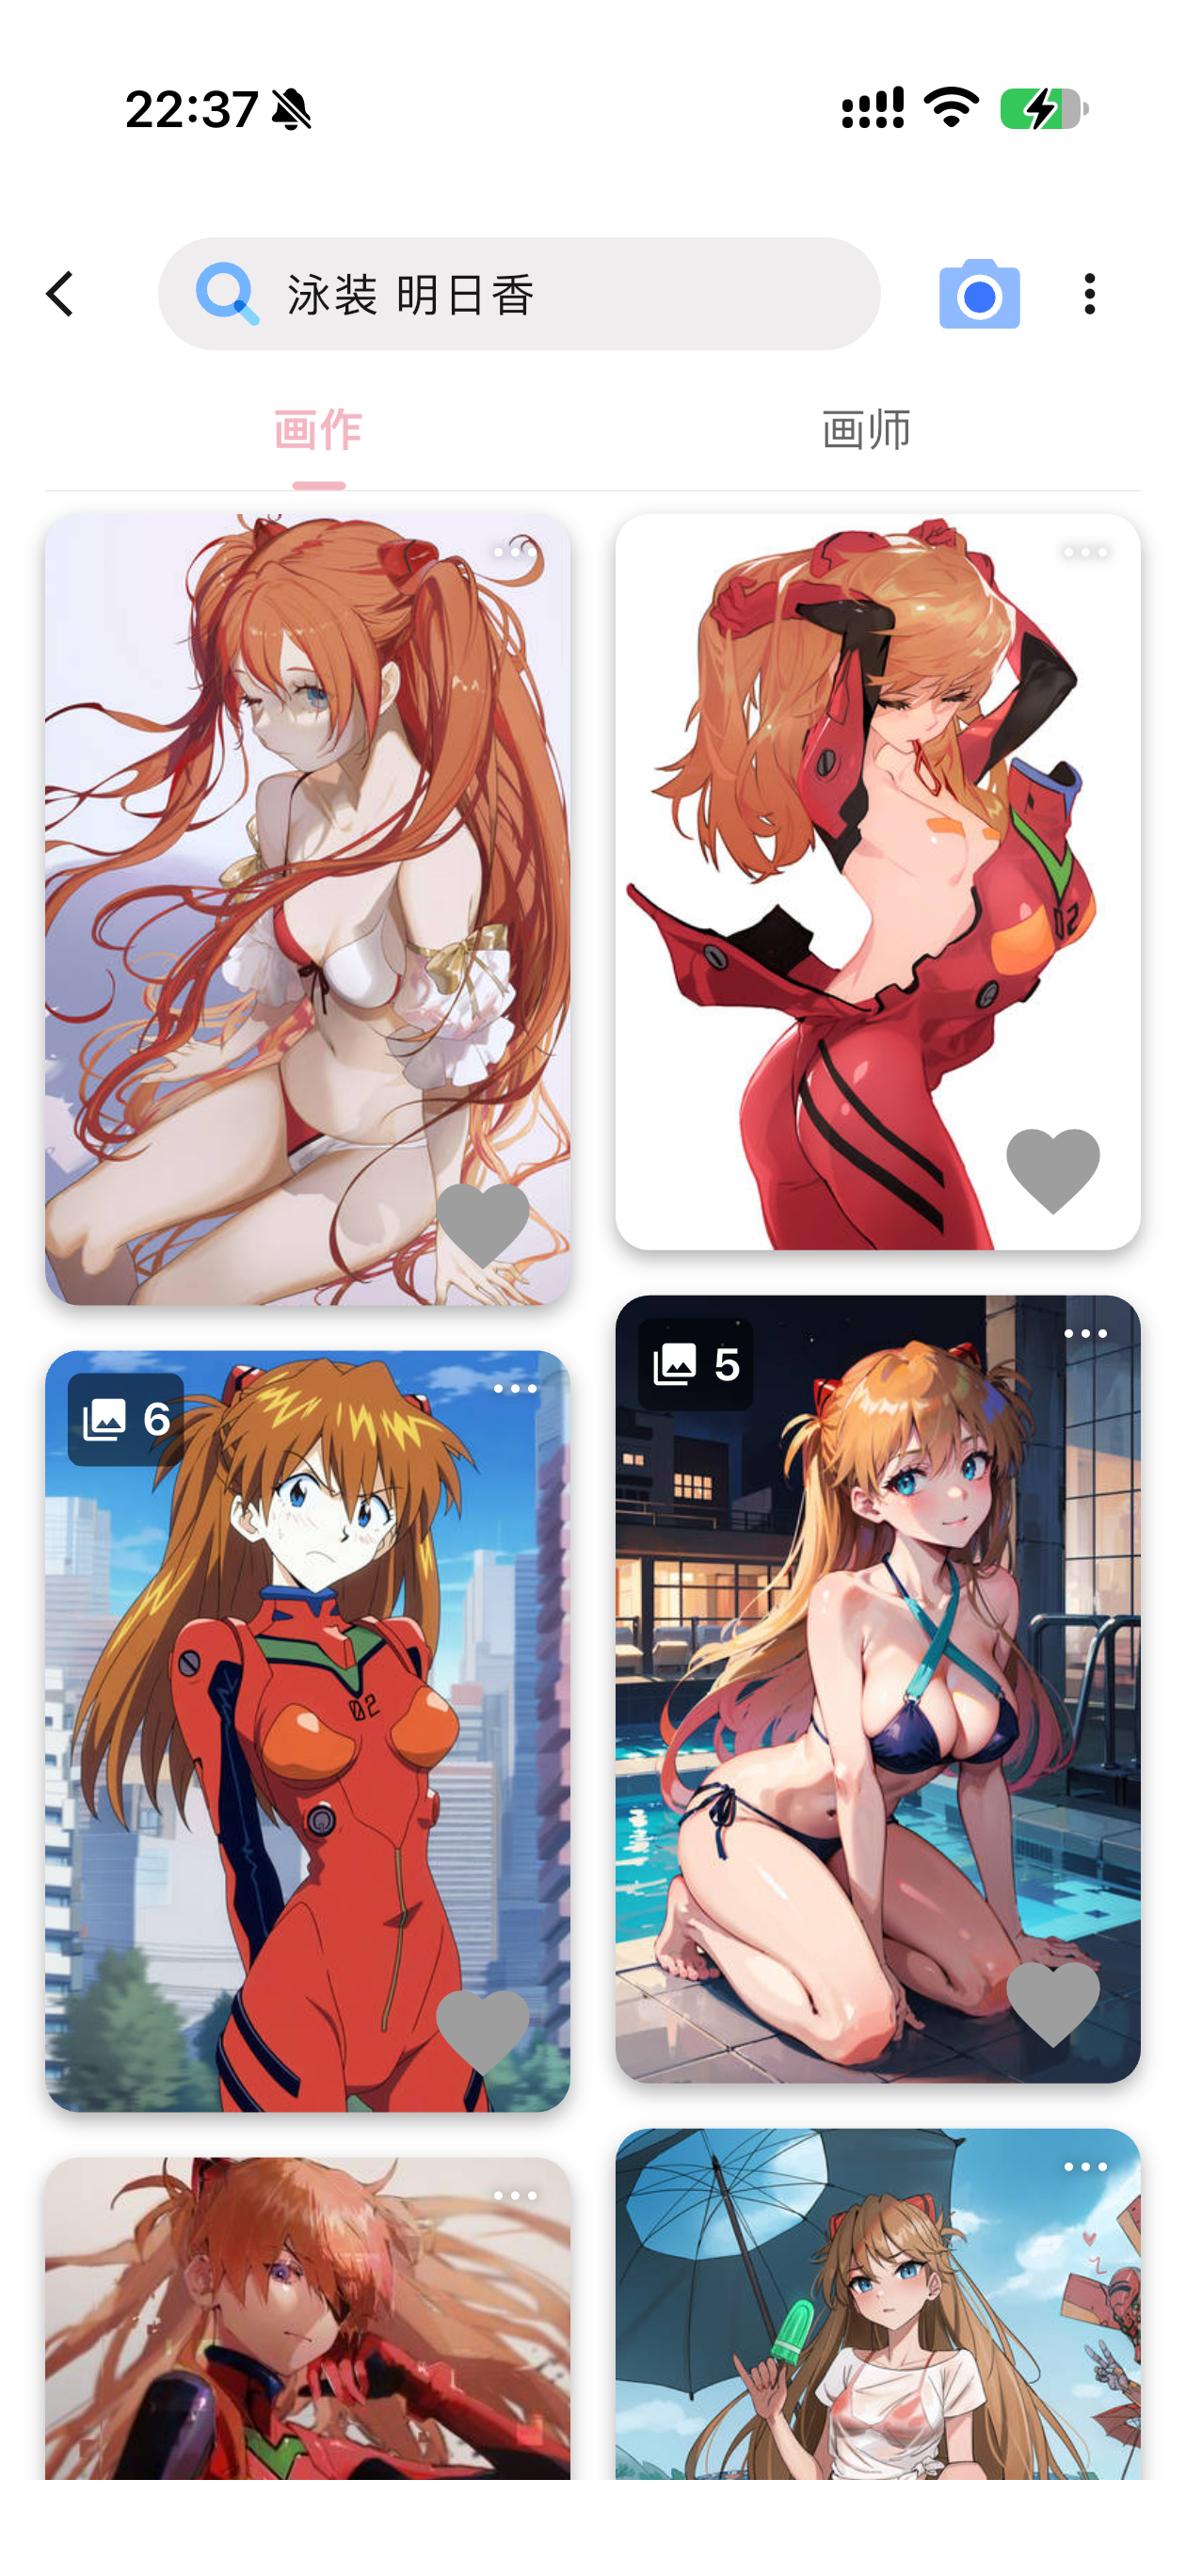
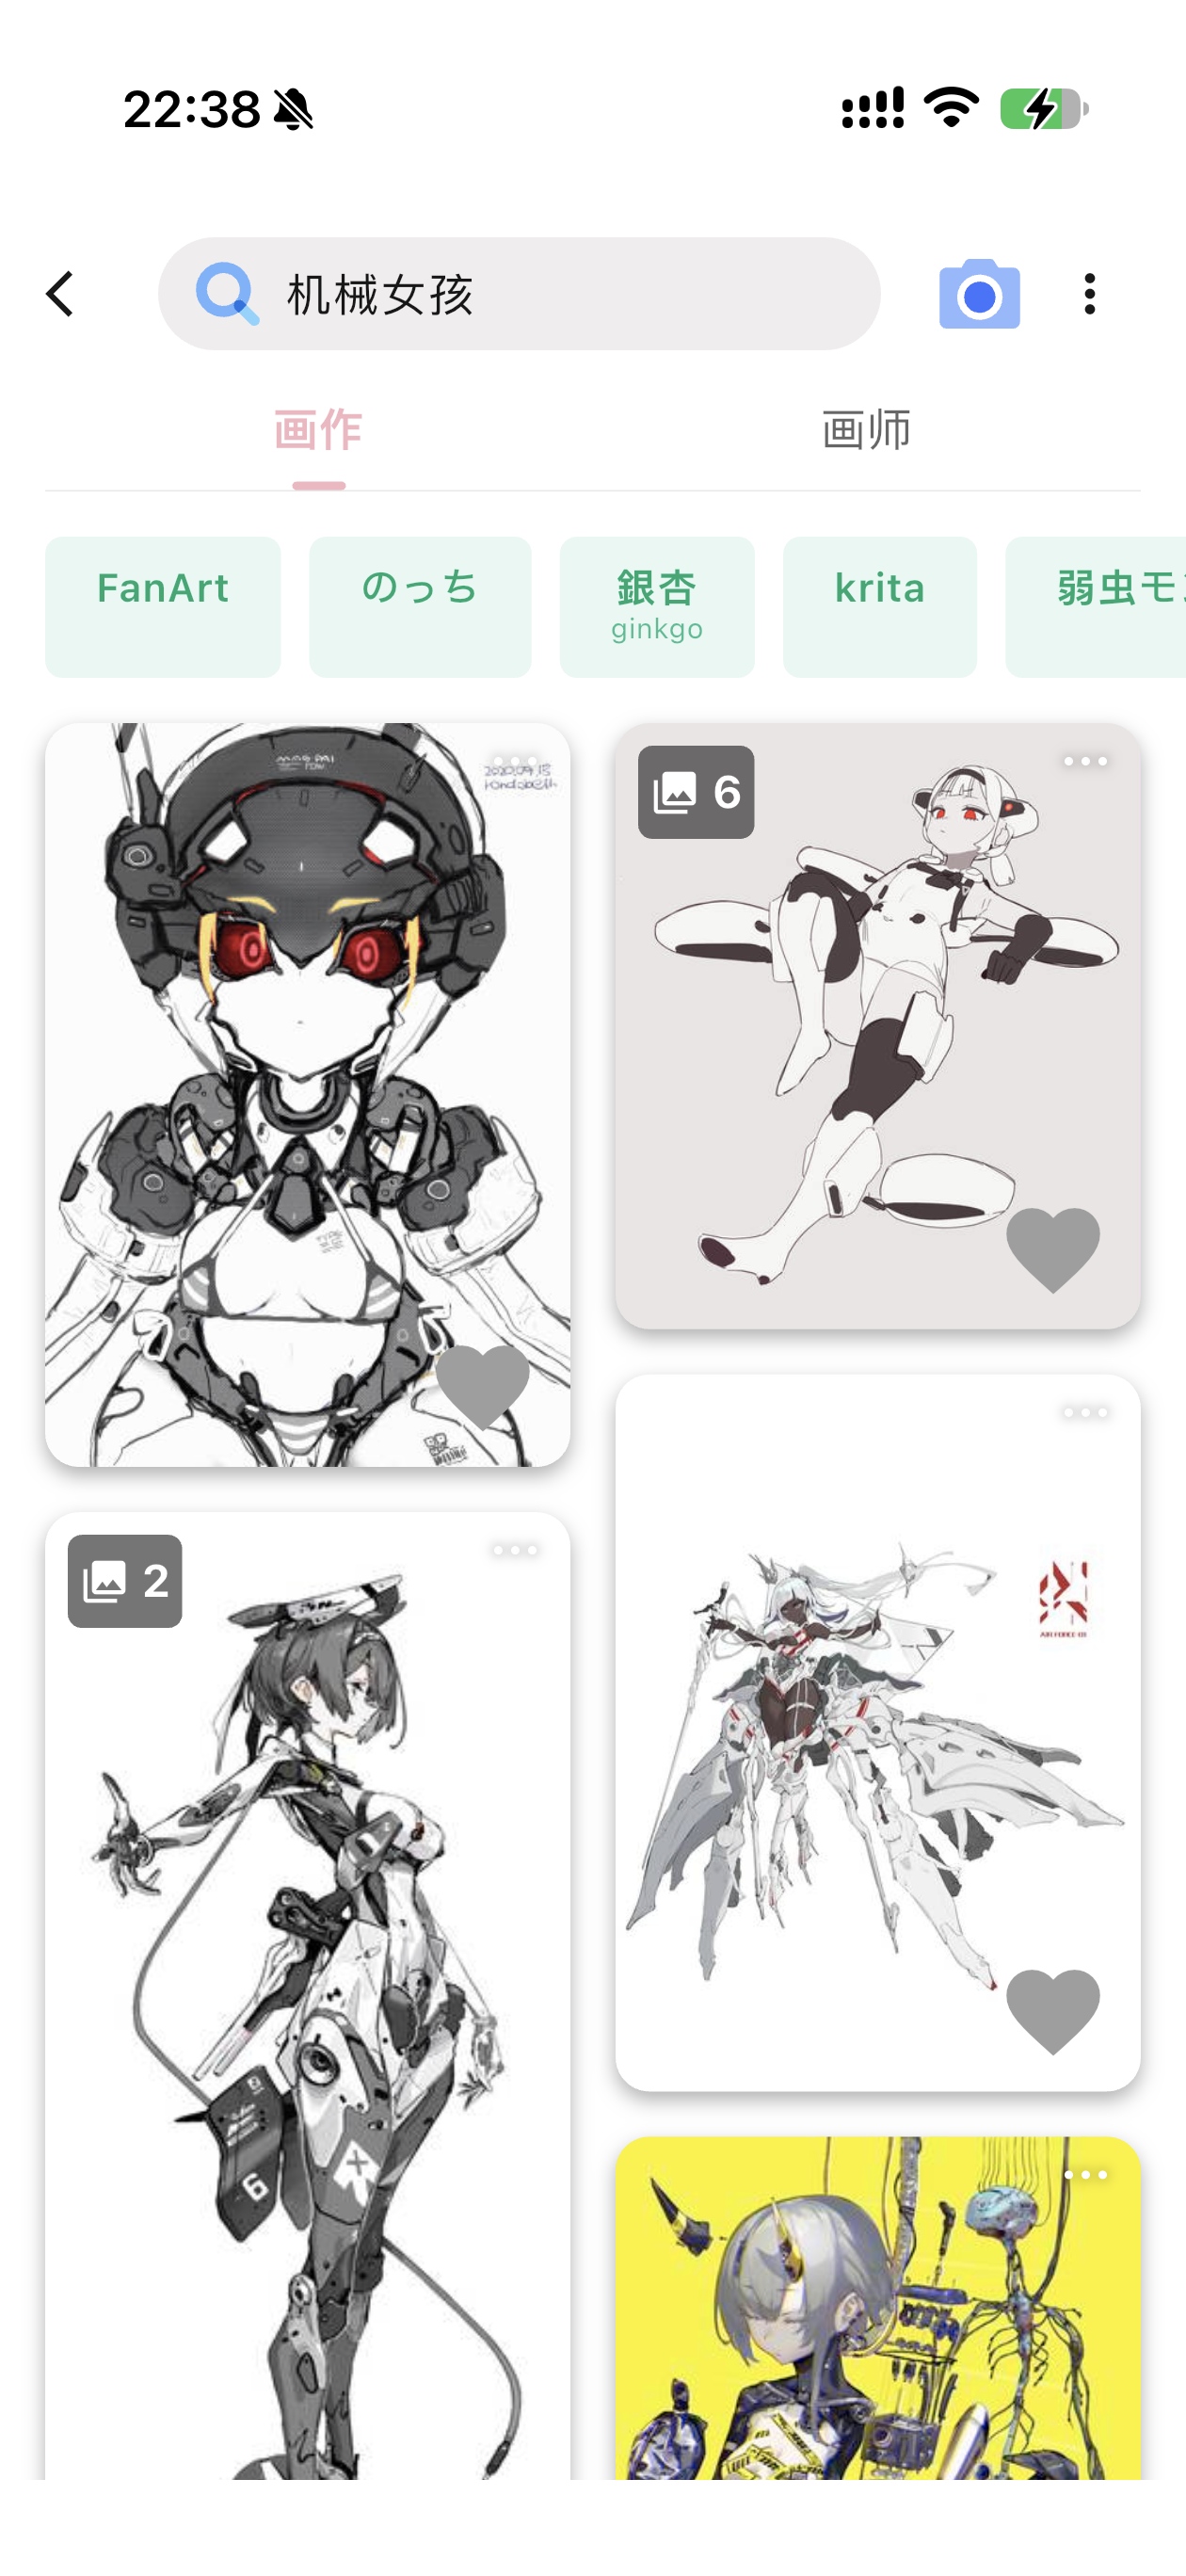
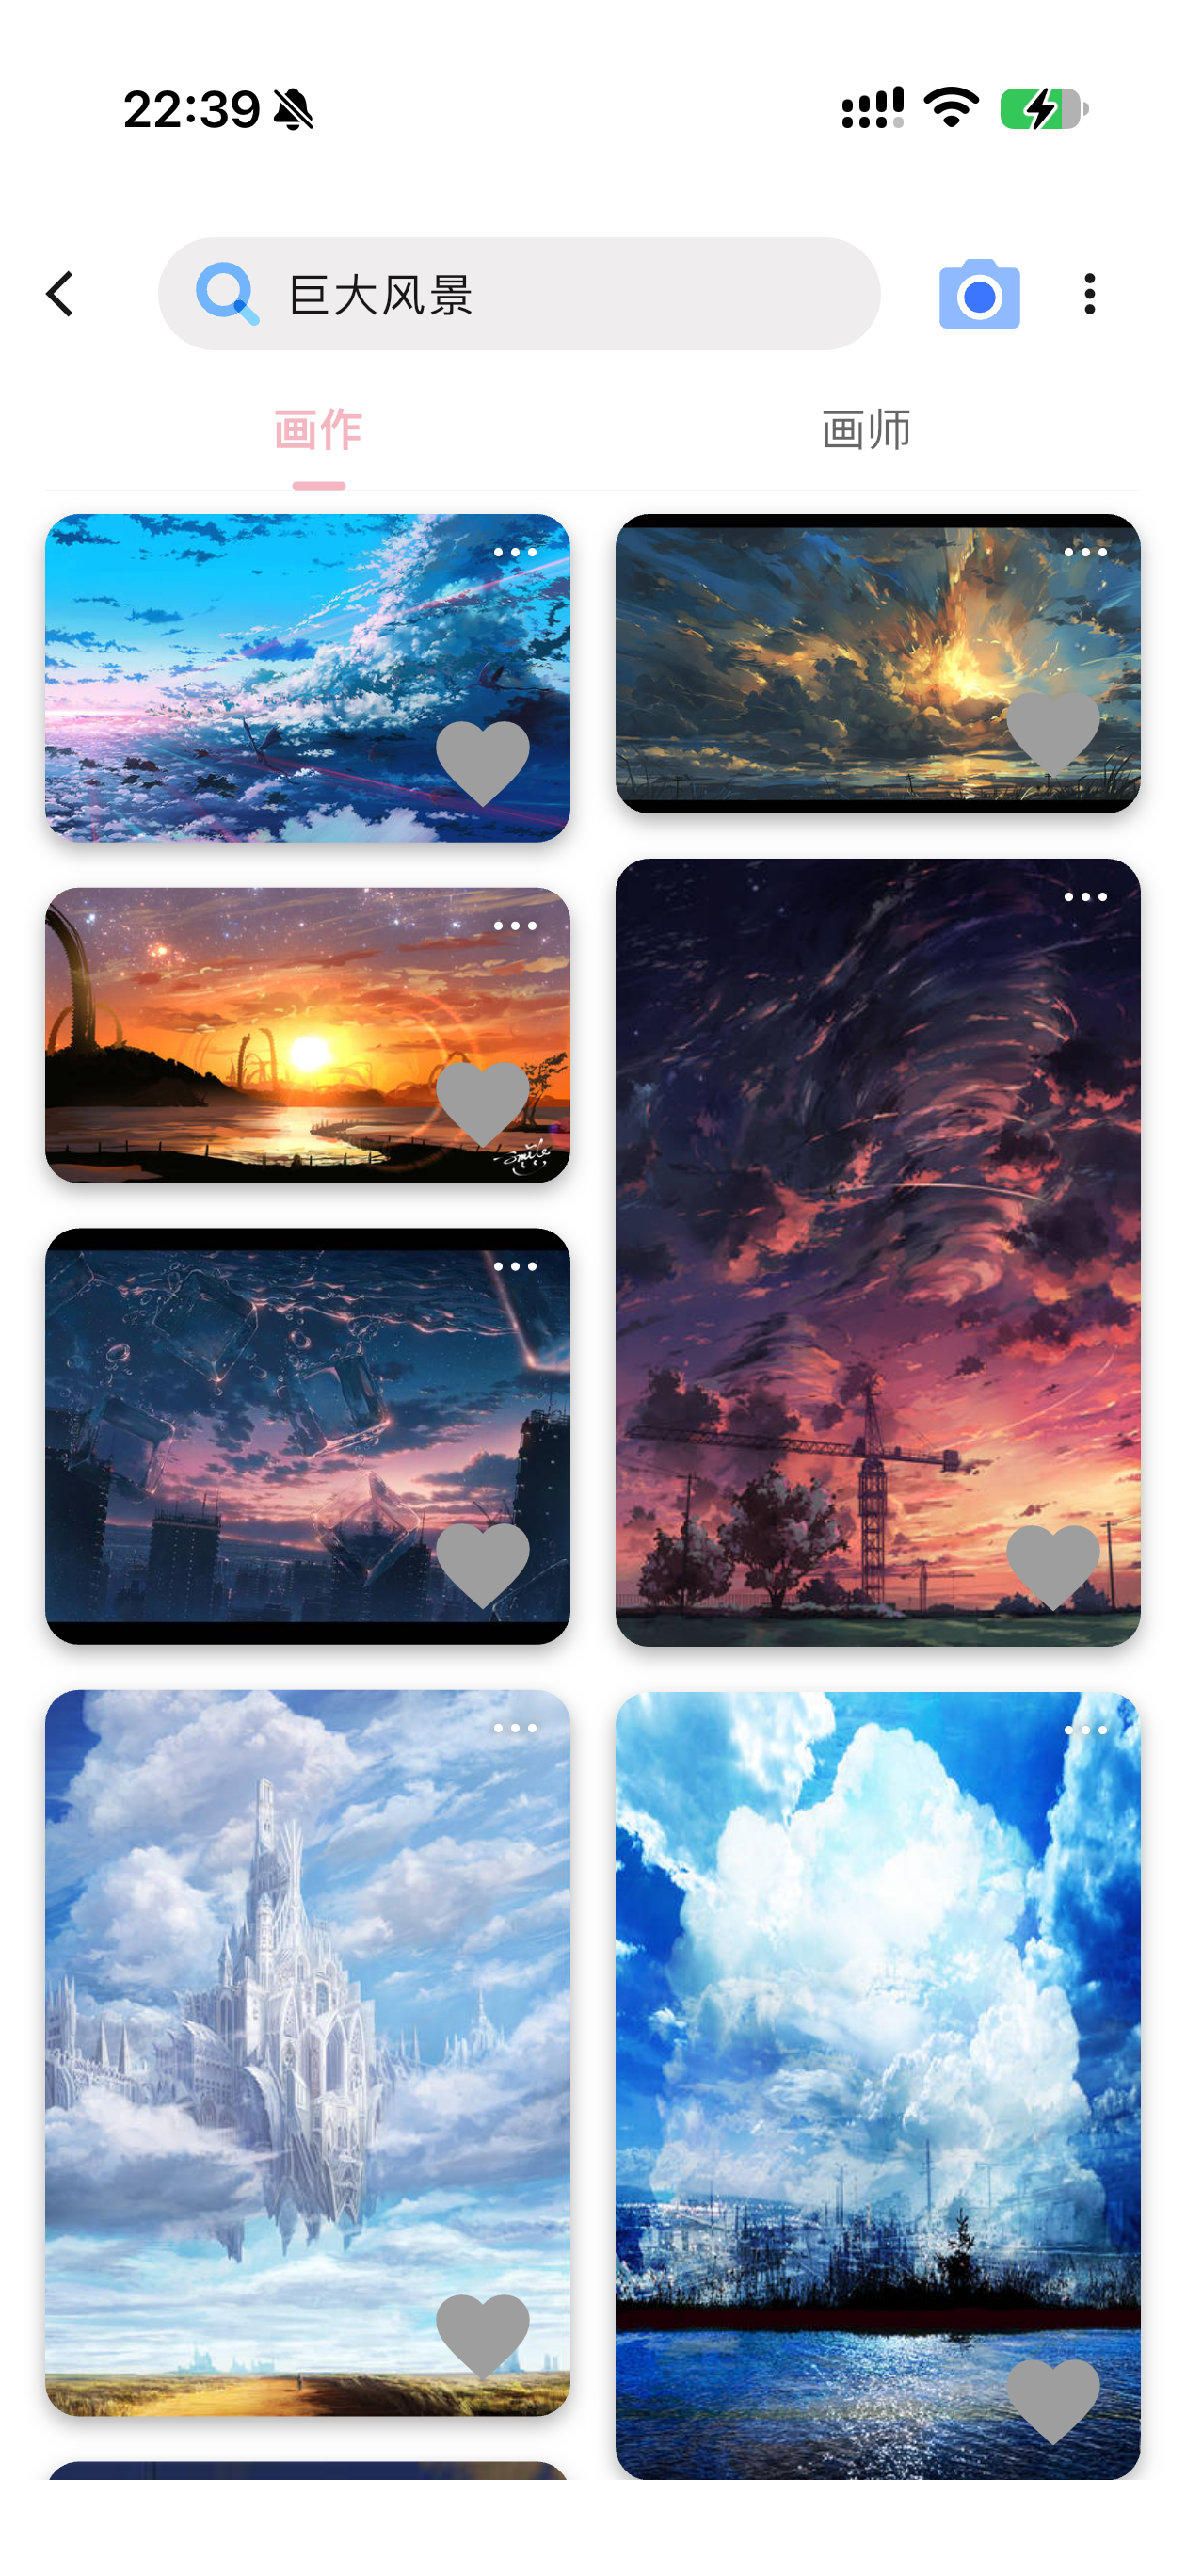
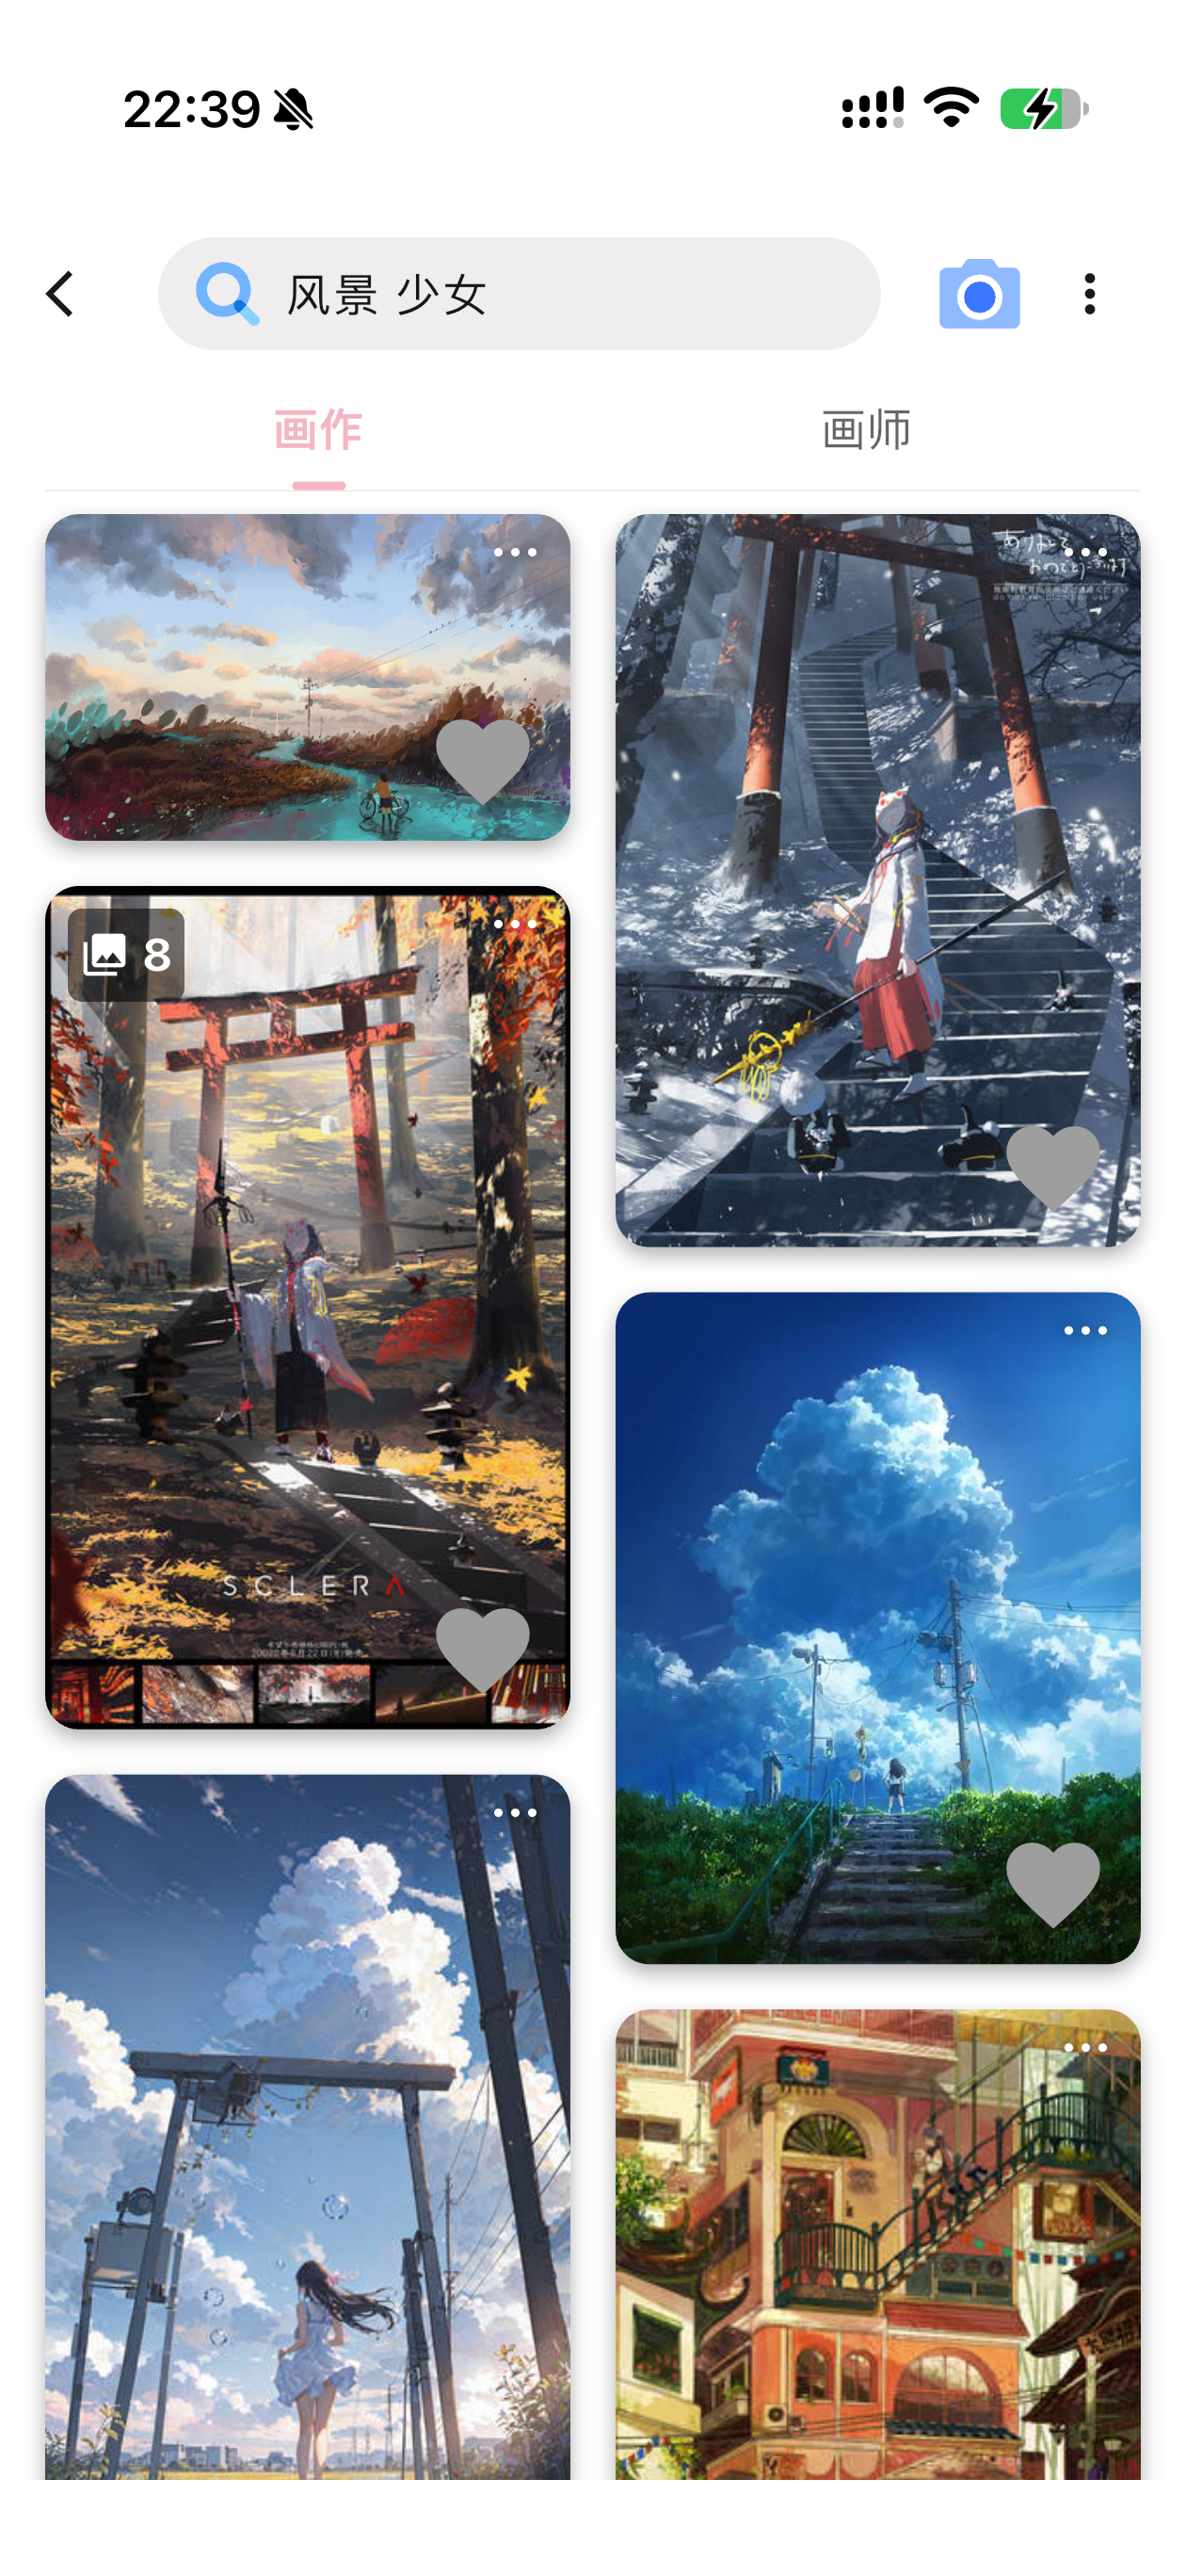
搜索 Case 展示
移动端搜索结果预览
|
|
|
|
|
|
|
|
emb 模型离线评估
当前结果来自三组文本到图像检索评估:单一标签、多标签组合和自然语言描述。Base 为原始 Qwen3-VL-Embedding-2B,Exp 为完成“单标签 1 epoch + 三类数据混合 2 epoch”后的 LoRA checkpoint。三组实验均使用 FAISS HNSW32,SQ8 量化 ANN 索引。
| 评估任务 | Query / 候选库 | 指标 | Base | Exp | 绝对提升 |
|---|---|---|---|---|---|
| 单一标签配对 | 576,240 / 3,430,274 | Recall@1 | 0.0339% | 0.1365% | +0.1026pp |
| 单一标签配对 | 同上 | Recall@10 | 0.1594% | 0.9010% | +0.7416pp |
| 单一标签配对 | 同上 | Recall@500 | 1.6632% | 10.0632% | +8.4000pp |
| 单一标签配对 | 同上 | HitRate@10 | 0.3483% | 1.7595% | +1.4112pp |
| 单一标签配对 | 同上 | MRR@10 | 0.1313% | 0.5960% | +0.4647pp |
| 单一标签配对 | 同上 | NDCG@10 | 0.1060% | 0.5326% | +0.4266pp |
| 单一标签配对 | 同上 | Precision@10 | 0.0368% | 0.1842% | +0.1474pp |
| 多标签组合配对 | 369,797 / 418,229 | Recall@1 | 1.9289% | 32.6541% | +30.7251pp |
| 多标签组合配对 | 同上 | Recall@10 | 6.1108% | 56.6138% | +50.5030pp |
| 多标签组合配对 | 同上 | Recall@500 | 22.6470% | 81.2649% | +58.6179pp |
| 多标签组合配对 | 同上 | HitRate@10 | 6.1796% | 57.5835% | +51.4039pp |
| 多标签组合配对 | 同上 | MRR@10 | 3.0716% | 40.5600% | +37.4884pp |
| 多标签组合配对 | 同上 | NDCG@10 | 3.7671% | 44.1927% | +40.4256pp |
| 多标签组合配对 | 同上 | Precision@10 | 0.6197% | 5.8601% | +5.2404pp |
| 自然语言描述配对 | 126,779 / 126,770 | Recall@1 | 60.6197% | 87.7472% | +27.1275pp |
| 自然语言描述配对 | 同上 | Recall@10 | 74.2544% | 94.9156% | +20.6612pp |
| 自然语言描述配对 | 同上 | Recall@500 | 83.1825% | 98.2742% | +15.0916pp |
| 自然语言描述配对 | 同上 | HitRate@10 | 74.2544% | 94.9156% | +20.6612pp |
| 自然语言描述配对 | 同上 | MRR@10 | 65.2370% | 90.2323% | +24.9953pp |
| 自然语言描述配对 | 同上 | NDCG@10 | 67.4217% | 91.3712% | +23.9495pp |
| 自然语言描述配对 | 同上 | Precision@10 | 7.4254% | 9.4916% | +2.0661pp |
每组评估的 25 项检索指标均实现提升,三组共 75 项指标保持一致改善。最明显的收益出现在多标签组合配对:Recall@10 从 6.1108% 提升到 56.6138%,Recall@500 从 22.6470% 提升到 81.2649%,说明领域微调显著改善了组合条件与图像之间的对齐。
自然语言描述配对的 Base 本身已有较强表现,Exp 仍将 Recall@1 从 60.6197% 提升到 87.7472%,将 Recall@10 从 74.2544% 提升到 94.9156%,同时 NDCG@10 从 67.4217% 提升到 91.3712%,说明不仅找回了更多目标,前排排序也得到改善。
单一标签配对的绝对分数仍然较低,但相对 Base 有稳定提升,例如 Recall@500 从 1.6632% 提升到 10.0632%。单标签通常对应大量图像,且当前评估存在多正例、未完整补全相关关系和潜在假负例,因此不能仅凭这组分数断言单标签语义能力不足;后续会结合人工 case、完整相关性标注和分桶指标继续验证。
获取
iOS: https://apps.apple.com/app/sharemoe/id1508873995
macOS:https://github.com/OysterQAQ/Blog-Image/blob/master/ShareMoe-1.0.6-macos-arm64.zip https://github.com/OysterQAQ/Blog-Image/blob/master/ShareMoe-1.0.6-macos-x64.zip
windows:https://github.com/OysterQAQ/Blog-Image/blob/master/ShareMoe-1.0.6-windows-amd64-installer.exe
 Select Language